Contexto del reporte
El 8 de junio de 2023 envié este hallazgo al programa de Snapchat en HackerOne. Afectaba al buscador de newsroom.snap.com y podía explotarse sin iniciar sesión. El equipo corrigió el problema y el reporte se divulgó públicamente el 14 de agosto de 2023.
Nota: este artículo documenta un caso histórico ya corregido. Las pruebas deben realizarse únicamente sobre sistemas propios o con autorización expresa.
El punto de entrada
La ruta de búsqueda recibía el texto mediante el parámetro q. Ese valor aparecía de nuevo en la interfaz, pero el navegador no lo trataba solamente como texto: interpretaba las etiquetas HTML incluidas en la consulta.
https://newsroom.snap.com/es-ES/search?q=<marcado_controlado>La diferencia es importante. Reflejar caracteres como texto solo cambia lo que se lee. Insertarlos en el DOM como HTML permite crear enlaces, alterar estilos y superponer elementos sobre el contenido legítimo.
Prueba de concepto
Primero confirmé la reflexión con un marcador reconocible. Después utilicé un enlace con estilos para demostrar que el contenido inyectado podía ocupar una zona destacada de la página. En esta versión uso un dominio reservado y un mensaje neutro:
<a href="https://example.invalid"
   style="position:absolute; padding:40px; z-index:1000">
  Enlace de demostración
</a>
El payload original quedaba codificado dentro de la URL. Al abrirla, el navegador construía el elemento <a> dentro de la página de resultados.
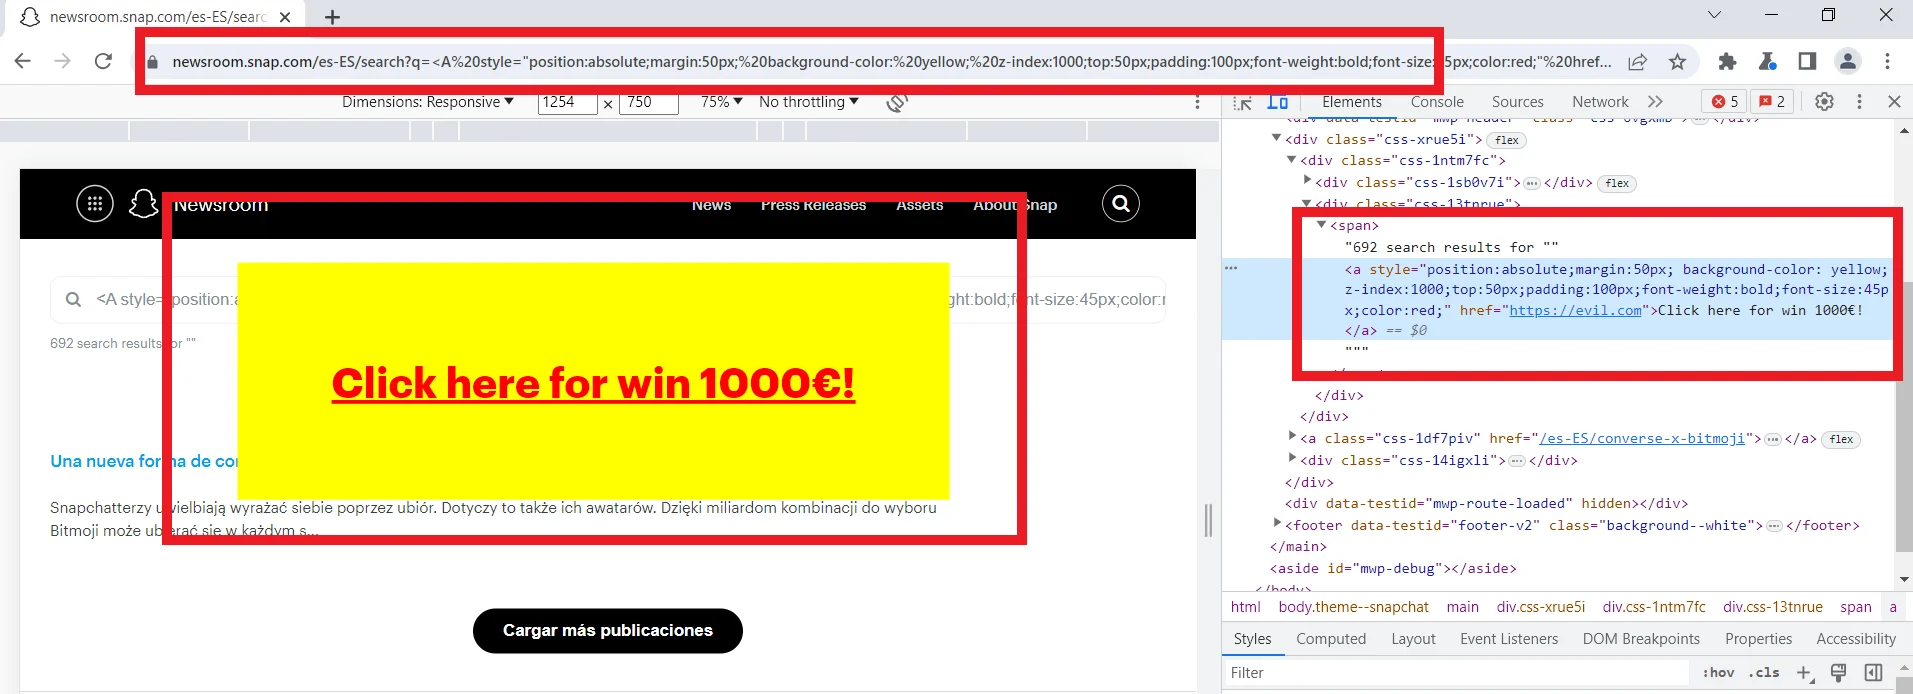
Impacto, sin inflarlo
La prueba demostró inyección HTML, no ejecución de JavaScript. Por eso no lo presenté como XSS. El impacto confirmado era la capacidad de modificar la composición visual, mostrar un mensaje convincente y dirigir a la persona a otro sitio desde una URL que comenzaba en un dominio real de Snapchat.
Ese contexto podía utilizarse para phishing o suplantación visual. La confianza aportada por el dominio legítimo aumentaba la credibilidad del señuelo, aunque la interacción final dependía de que la víctima abriera el enlace y pulsara sobre el contenido inyectado.
Cómo se corrige
- Insertar el término de búsqueda con APIs que lo traten como texto, no como HTML.
- Aplicar codificación de salida según el contexto donde se muestre el valor.
- Evitar funciones como
innerHTMLpara representar entradas no confiables. - Añadir pruebas de regresión con etiquetas, atributos y caracteres especiales.
- Usar una Content Security Policy como defensa adicional, no como sustituto del escape correcto.
Lo que me llevé del caso
Un buscador parece una superficie sencilla, pero combina entrada, renderizado y confianza visual. La clave fue separar con precisión lo demostrado de lo hipotético: había control sobre HTML y estilos, pero no evidencia de ejecución de scripts.
Ese alcance bien definido hizo que el reporte fuera fácil de reproducir y que el impacto quedara explicado sin exageraciones.
Ver reporte público original en HackerOne ↗